
Der Harness, also die Software-Umgebung um ein KI-Modell, entscheidet über einen großen Teil der Ergebnisqualität: Dasselbe Modell löste im Composio-Vergleich je nach Harness zwischen 17 und 22 von 25 Aufgaben. Die Grenze liegt im Aufbau, denn getestet wurde Kimi K3 über OpenRouter, Claude Code und Codex liefen also nicht mit ihren eigenen Modellen. Die Zahlen stammen aus dem Bericht vom 4. August 2026, die Erklärung der Bausteine aus dem Video von Alex Sprogis vom 3. November 2026.
Was ein Harness ist: Die Küche, in der das Modell überhaupt kochen kann
Ein Harness ist laut Alex Sprogis die Software rund um ein Sprachmodell, die Werkzeuge, Kontext und Prüfungen bereitstellt und das Modell erst zum Agenten macht. Das Modell allein sagt im Kern nur Text voraus. Es sieht Ihre Dateien nicht, führt keinen Befehl aus und startet jede Sitzung bei null. Sprogis vergleicht es mit einem Koch ohne Küche: Er kann erzählen, wie das Gericht geht, mehr nicht.
Modell plus Harness ergibt den Agenten. Anthropic beschreibt Claude Code laut Sprogis genauso, nämlich als Schicht, die Tools bereitstellt und den Kontext verwaltet. Wer Claude Code in der Desktop-App öffnet, sieht nur die Oberfläche. Dahinter arbeitet unsichtbar der Harness.
Alle Bausteine laufen im Agent Loop. Das Modell plant den nächsten Schritt und wählt einen Tool Call, also einen Werkzeugaufruf. Der Harness prüft die Berechtigung, führt das Werkzeug aus und gibt das Ergebnis zurück. Dann beginnt die Runde von vorn, bis die Aufgabe erledigt ist.
Die Tabelle zeigt die vier Bausteine, die Sprogis unterscheidet.
| Baustein | Inhalt | Beispiele |
|---|---|---|
| Kontext | System Prompt, Umgebungsinfos, Regeldatei, Gedächtnis | CLAUDE.md, AGENTS.md, Auto Memory |
| Werkzeuge | Dateien, Terminal, Websuche, externe Systeme | Tool Calls, MCP |
| Verifikation | Prüfung der eigenen Arbeit | Unit-Tests, Linter, Hooks |
| Berechtigungen | Kontrolle jedes Tool Calls | Auto-Modus, Sandbox |
Der Kontext macht in der Praxis die meisten Probleme. Das Kontextfenster gleicht laut Sprogis einem Glas Wasser: Je voller es wird, desto schlechter filtert das Modell Wichtiges heraus. Dieses Phänomen heißt Context Rot. Als Gegenmittel verdichtet der Harness den Verlauf zu einer Zusammenfassung, der Compaction, und verwirft den Rest. Dabei gehen Details verloren. Darum erklärt man einem Agenten manchmal alles doppelt. Mit /compact lösen Sie die Verdichtung selbst aus, mit /memory sehen Sie, was sich Claude Code gemerkt hat.
Tipp: Schreiben Sie Regeln, die jede neue Sitzung kennen soll, in die CLAUDE.md oder die AGENTS.md, denn Dateien überstehen jede Compaction.
Werkzeuge folgen einem simplen Muster. Das Modell schreibt, welches Tool es aufrufen will, und die Software führt den Aufruf wirklich aus. Über MCP, das Model Context Protocol, lassen sich externe Systeme wie Notion oder ein CRM anbinden. Für das Modell entsteht daraus eine einzige lange Werkzeugliste.
Prüfungen sind der Taschenrechner des Agenten. Sprachmodelle rechneten laut Sprogis lange unzuverlässig, bis man ihnen einen Taschenrechner als Tool gab. Beim Programmieren übernehmen Unit-Tests, also automatische Funktionsprüfungen, und Linter, die Code auf typische Fehler durchsuchen, diese Rolle. Ein Hook startet die Tests nach jeder Änderung von selbst, auch wenn das Modell nicht daran denkt.
Berechtigungen schützen Sie selbst. Sprogis berichtet, Opus 5.5 habe zuletzt eine komplette Datenbank gelöscht. Deshalb prüft der Harness jeden Tool Call vor der Ausführung. Im Auto-Modus von Claude Code blockiert ein Klassifizierer riskante Befehle, statt jedes Mal zu fragen. Eine Sandbox, also eine abgeschottete Umgebung, schalten Sie mit /sandbox ein. Auch Copilot lässt ein Prüfmodell über Terminalbefehle entscheiden.
Acht Harnesses, ein Modell: 20 Prozentpunkte Abstand bei den gelösten Aufgaben
Composio ließ laut Bericht vom 4. August 2026 das Modell Kimi K3 in acht Umgebungen dieselben 25 Aufgaben lösen. Anbieter, Denktiefe, Werkzeuge und Aufgabentexte blieben gleich. Die Werkzeuge waren gehostete Composio-MCP-Tools für Gmail, Google Calendar, Google Sheets, Airtable, GitHub, Slack, Notion, Linear und PagerDuty. Automatische Prüfungen kontrollierten den Endzustand der Anwendungen. Eine selbstsichere Abschlussmeldung des Agenten konnte eine falsche Lösung nicht retten.
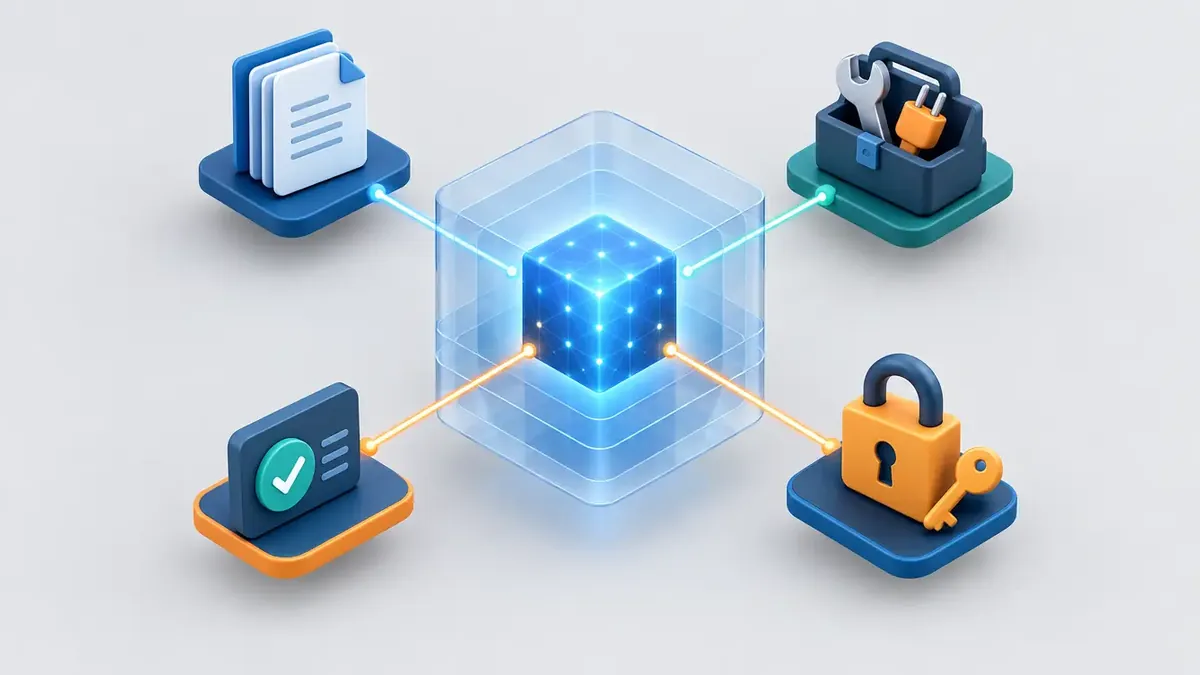 Dieses Bild wurde mit KI generiertProviderhiggsfieldModellgpt_image_2_5 flare high 1k 16:9PromptIsometric 3D illustration: a glowing cube representing an AI model floats at the center of a transparent, layered shell. Four distinct modules attach to the shell: a stack of document pages for context, a small toolbox with wrench and plug for tools, a panel with a checkmark for verification, and a padlock with a key for permissions. Thin glowing lines connect each module to the cube. Clean light gray background, soft shadows, palette of deep blue, teal and warm orange accents, matte plastic and glass materials. Schematic, no numbers, no text, no charts. No watermark, no signature.
Die Tabelle zeigt für alle acht Harnesses die bestandenen Aufgaben, die mediane Laufzeit und die geschätzten Kosten je bestandener Aufgabe.
| Harness | Bestanden | Laufzeit (Median) | Kosten je Erfolg (USD) |
|---|---|---|---|
| Oh My Pi | 22 von 25 | 231,7 s | 0,52 |
| Kimi Code | 21 von 25 | 281,9 s | 0,64 |
| Hermes Agent | 20 von 25 | 164,0 s | 0,46 |
| Claude Code | 19 von 25 | 330,5 s | 1,96 |
| Pi Agent | 18 von 25 | 156,2 s | 0,57 |
| OpenCode | 18 von 25 | 270,5 s | 0,72 |
| Grok Build | 18 von 25 | 196,2 s | 0,66 |
| Codex | 17 von 25 | 233,4 s | 0,66 |
Die Kosten sind Schätzungen auf Basis der OpenRouter-Listenpreise vom 30. Juli 2026. Sie beziehen sich auf 24 Aufgaben, weil für eine Aufgabe Nutzungsdaten fehlten. Claude Code hatte laut Composio die längste Laufzeit und mit 35,37 US-Dollar die höchsten geschätzten Gesamtkosten. Mit 1,96 US-Dollar je Erfolg liegt es weit vor OpenCode, dem Zweitplatzierten der Kostenliste. Dabei gilt für Claude Code und Codex dieselbe Einschränkung: Beide arbeiteten mit einem fremden Modell, ein Test mit Claude kann laut Composio anders ausgehen.
Mehr Aktionen brachten keinen Vorteil. Grok Build setzte 402 Tool Calls ab, Pi Agent nur 223, beide bestanden 18 Aufgaben. Pi war am schnellsten und kam mit den wenigsten Token aus, bestand aber weniger Aufgaben als die Spitze. Eine Berechtigungsgrenze bringt Pi laut Composio nicht mit, wer Isolation will, ergänzt einen Container oder eine Sandbox. Hermes Agent, laut GitHub-Seite ein quelloffener Agent von Nous Research mit lernendem Gedächtnis, hatte mit 0,46 US-Dollar die niedrigsten Kosten je Erfolg.
Wenn der Agent zu früh Feierabend macht: Was die gemischten Aufgaben verraten
Die zehn Aufgaben mit gemischtem Ergebnis zeigen den Einfluss des Harness laut Composio am deutlichsten. Zwölf Aufgaben bestanden alle acht Harnesses, an drei scheiterten alle. Dazwischen änderte sich nur die Umgebung: Kontext, Planung, Werkzeugbehandlung und Abbruchverhalten.
Beim CRM-Migrationsarchiv bestanden Hermes Agent, Claude Code, OpenCode und Oh My Pi. Hermes brauchte dafür 27 Tool Calls und 545 Sekunden. Kimi Code stoppte nach fünf Tool Calls und meldete 222 neue Abonnements statt der korrekten 354. Auch den Tarif mit dem größten Umsatzrückgang wählte es falsch. Im Ernst: Fünf Aufrufe für zehn Quartale Abodaten sind knapp.
Das Übergabe-Audit bestanden nur Kimi Code, OpenCode und Oh My Pi. Grok Build machte mehr Aufrufe als jede der drei und scheiterte trotzdem. Laut Composio spielen auch die Reihenfolge der Aktionen und die Informationen im Kontext eine Rolle.
Beim Erstattungs-Audit lief Codex in das feste Limit von 900 Sekunden und endete mit einem Fehler. Pi Agent bestand die Aufgabe in 446 Sekunden mit 16 Tool Calls und rund 995.000 Token. Kimi Code bestand ebenfalls, brauchte aber fast doppelt so lang und verarbeitete rund 2,93 Millionen Token.
Bei der Rechnungssynchronisation scheiterten alle acht. Die meisten nahmen zwei Rechnungen auf, die ausgeschlossen bleiben sollten. (Immerhin scheitert auch das teuerste Setup an denselben drei Aufgaben wie das günstigste.)
Composio führt solche Ausreißer auch darauf zurück, wann ein Harness den Agenten für fertig hält. Manche Umgebungen verlangen eine Schlussprüfung, andere stoppen nach der Hauptaktion. Bei Ausschlüssen, exakten Zahlen und abhängigen Updates fällt das ins Gewicht. Eine einzelne Ursache je Ergebnis kann der Vergleich nicht benennen. Einen Agenten zu bauen, der sauber aufhört, klingt einfach, ist es aber nicht.
Vom Prompt zum Harness: Wie Agenten Runde für Runde arbeiten
Harness Engineering bezeichnet das Gestalten der gesamten Umgebung und des Ablaufs, in dem ein Agent arbeitet, und baut laut Alex Sprogis auf Prompt und Context Engineering auf.
Prompt Engineering prägte die Zeit ab Ende 2022, als ChatGPT erschien und das Kontextfenster noch klein war. Mit Tool Calls und MCP rückte das Context Engineering nach vorn, also die Frage, welche Informationen im Kontextfenster landen. Warum Unternehmen ihre Agenten nicht länger über Prompt-Ketten steuern sollten, behandelt unser Beitrag zur Agents API. Bei mehrstündigen Aufgaben stößt auch Context Engineering an Grenzen: Das Fenster füllt sich, nach der Compaction fehlen Details, und der Agent hält sich für fertig, obwohl die Hälfte fehlt.
Prompt und Kontext bleiben Teil des Harness. Der Prompt stößt die Aufgabe an, der Kontext liefert, was der Agent sehen muss, und der Harness stellt den Ablauf bereit und prüft, wann der Agent wirklich fertig ist.
Sprogis beschreibt einen bewährten Ablauf mit vier Schritten.
- Legen Sie neben dem Briefing oder einem Product Requirements Document (PRD) eine Liste aller geplanten Features an.
- Lassen Sie den Agenten pro Runde genau ein Feature bearbeiten.
- Starten Sie jede Runde mit frischem Kontext, in der sich der Agent zuerst den Ist-Zustand holt.
- Testen Sie das Feature, committen Sie den Stand und gehen Sie dann zum nächsten Feature über.
Sprogis nennt das eine erste Einordnung. Ausbaustufen sind getrennte Phasen und unabhängige Agenten, die ihre Ergebnisse gegenseitig prüfen. Das Modell bleibt vorrangig für die Ergebnisqualität verantwortlich, die Umgebung steuert aber einen großen Teil bei. Ein Bastelprojekt muss das nicht werden.
Als nächster Schritt bietet sich an, für ein kleines Projekt die Feature-Liste anzulegen und die erste Runde mit leerem Kontext zu starten. Offen bleibt, wie Claude Code und Codex mit ihren eigenen Modellen abschneiden: Composio hat ausschließlich Kimi K3 gemessen.
Video-Tipp: Hör auf Agents zu prompten. Starte mit Harness Engineering!
Quelle: Alex Sprogis / Youtube.com

Was halten Sie von dem Thema? Hier können Sie mit anderen Leserinnen und Lesern ins Gespräch gehen.
Mitreden & diskutieren
Ihre Meinung zählt — teilen Sie Gedanken, Fragen oder Erfahrungen zu diesem Artikel.