München, 4. November 2026 – Nach einem weiteren Jahr im KI-Dauerhype machen sich erste Ermüdungserscheinungen bemerkbar. Was sich immer deutlicher abzeichnet: Ein leistungsfähiges Modell allein garantiert keinen Erfolg. Die Graph Intelligence Experten von Neo4j zeigen, wo Unternehmen 2027 bei KI ansetzen und umdenken müssen.
1. KI-Ernüchterung: Zwischen Anspruch und Wirklichkeit
Der Investitionsdruck steigt. Hieß es im letzten Jahr noch „Wo bleibt der ROI?“, fragen sich Unternehmen mittlerweile: „Was kostet uns der Versuch, ihn zu erzielen?“ Laut einer McKinsey-Studie vom August 2026 berichten 80 Prozent der Befragten von individuellen Produktivitätssteigerungen durch Künstliche Intelligenz. Doch nur 37 Prozent sehen auch einen positiven EBIT-Beitrag auf Unternehmensebene.
Die milliardenschweren Investitionen schlagen sich also längst nicht im erhofften Umfang in den Geschäftsbilanzen nieder. Gleichzeitig wird KI immer teurer. Unter anderem durch den Einsatz von Agentic AI: Agenten übernehmen komplexe, mehrstufige Workflows, die ein Vielfaches an Rechenleistung verschlingen, da sie in Schleifen iterieren, bis Ergebnisse erzielt werden. Selbst bei sinkenden Tokenpreisen steigen damit die Gesamtkosten (Inference Paradox).
KI ist damit ein Stück weit entzaubert. Für 2027 rücken neben den technologischen Möglichkeiten verstärkt die wirtschaftlichen und organisatorischen Voraussetzungen für einen erfolgreichen KI-Einsatz in den Fokus.
2. Datenqualität und Datensouveränität
Als NVIDIA-Chef Jensen Huang KI als fünfschichtige Torte präsentierte, ließ die Kritik nicht lange auf sich warten. Denn sein Rezept aus Energie, Chips, Infrastruktur, Modellen und Anwendungen lässt eine entscheidende Zutat vermissen: die Daten, die KI mit der Unternehmensrealität verbinden.
Laut einer Accenture-Studie verfügen gerade einmal sieben Prozent über die nötigen Fähigkeiten im Datenmanagement, um fortgeschrittene KI im großen Maßstab einzusetzen. Investitionsbedarf besteht seit Jahrzehnten. 2027 dürfte der Handlungsdruck jedoch endgültig zu groß sein, um das Problem weiter aufzuschieben. Leider gibt es für schlechte Daten keinen magischen Workaround. KI kann bei der Aufbereitung helfen, aber weder fehlende Informationen herbeizaubern noch ungeklärte Prozesse oder Datenmodelle definieren. An Datenqualität, Data Engineering, Data Management und Data Hygiene führt deshalb kein Weg vorbei.
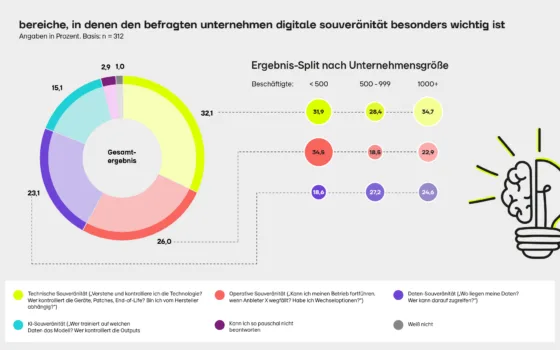
Datenkontrolle ist zudem eine Frage von digitaler Souveränität. Unternehmen müssen wissen, wo ihre Daten liegen, wem sie gehören und wer sie nutzen darf. Der Serverstandort allein garantiert keine Unabhängigkeit. Datenhoheit bedeutet auch, den Anbieter wechseln zu können, ohne das angesammelte Wissen zurückzulassen. Hier soll der EU Data Act zumindest auf regulatorischer Ebene Erleichterung bringen.
3. Wissen ist Macht, Kontext ist King
Daten allein machen noch kein Wissen. Kunden, Produkte, Prozesse und Entscheidungen – im Prinzip sind Informationen immer miteinander verknüpft. Das Problem: Ein Großteil des Unternehmenswissens ist in Systemen verstreut oder schlummert als implizites Wissen (Tacit Knowledge) in den Köpfen von Mitarbeitenden. Die Herausforderung besteht darin, beides zu erfassen und für KI explizit verfügbar zu machen. Anders als Menschen können diese nicht einfach flexibel nachfragen oder nachforschen, wenn etwas unklar oder unbekannt ist.
Wer einem KI-Agenten viele Terabyte an Informationen vor die Füße kippt, darf nicht erwarten, dass er sich damit zurechtfindet. Das KI-Modell ertrinkt in der Datenflut. Welche Informationen braucht sie wirklich? Wie wurde die Aufgabe bisher erledigt? Welche Regeln, Abläufe und Berechtigungen gelten? Genau darum geht es bei Kontext.
2027 wird die KI-gerechte Aufbereitung von Wissen zur Wettbewerbsdisziplin. Statt für jedes KI-Projekt Kontext neu zusammenzutragen, bauen Unternehmen eine zentrale Wissensschicht (Knowledge Layer) auf, die Anwendungen und Agenten wiederholt nutzen können.
4. Graphen in der KI-Architektur
Context Layer, Knowledge Layer, Semantik, Ontologien – rund um die Wissensschicht in der KI-Architektur gibt es zahlreiche Begriffe und Konzepte. Im Kern geht es darum, KI-Systemen genau die (Meta-)Informationen bereitzustellen, die sie brauchen, um ihre aktuelle Situation im Zusammenhang zu verstehen.
Graphdatenbanken bilden dafür Zusammenhänge und Beziehungen ab, von Informationen und Abhängigkeiten über Prozesse und Kontrollsysteme bis zur Orchestrierung komplexer Agentensysteme. Gartner zum Beispiel beschreibt sogenannte Context Graphs als nächste Entwicklungsstufe von Knowledge Graphen. Sie bilden neben den vernetzten Daten auch Entscheidungslogik, Workflows, Event Tracing und Zustandsmanagement ab.
2027 wird der Knowledge Layer auf Basis von Graphtechnologie damit zum festen Bestandteil der Enterprise-KI-Architektur. Entscheidend ist ein Umdenken in Sachen Wissenshoheit: Vernetztes Geschäftswissen gilt als strategisches Kapital, unabhängig von Modellen, Agenten und Softwareanbietern. Sowohl selbst entwickelte als auch eingekaufte Anwendungen sollen darauf zugreifen können.
5. KI-Modelle: Kleiner, schneller, spezialisiert
Claude Opus 5.5, GPT-6 Astra und Gemini 4 Carbon – die großen KI-Anbieter liefern sich weiterhin ein Wettrüsten um immer leistungsfähigere Modellgenerationen. Abseits des Hypes um generative KI kommen jedoch längst spezialisierte Modelle zum Einsatz, etwa in der Wetter- und Klimaforschung oder der Materialwissenschaft oder der Genomik. Andere unterstützen konkrete Entscheidungen durch schnelle Bewertungen oder Klassifikationen (decision models).
Diese Modelle lassen weniger Raum für Halluzinationen und Fehler. Zudem sind sie schneller und kostengünstiger – teilweise um das 100- bis 1.000-Fache als LLMs. Direkt in Softwareanwendungen eingebettet, bieten sie eine hohe Performance und Flexibilität. Auch Open-Weight-Modelle wie Kimi, GLM, DeepSeek, haben stark aufgeholt und reichen mittlerweile für viele Aufgaben aus.
2027 werden Unternehmen verstärkt auf kleinere, spezialisierte und kosteneffiziente KI-Lösungen setzen. Dazu gehören auch Modelle mit Finetuning, die gezielt auf bestimmte Aufgaben zugeschnitten sind. Databricks zum Beispiel nutzt erfolgreiche Abläufe von KI-Agenten, um Modelle individuell zu trainieren und anzupassen.
6. Agent Memory: Aus Erfahrung lernen
Das größte ROI-Potenzial von KI liegt nicht unbedingt in der Generierung von Inhalten, sondern in der Ausführung komplexer Aufgaben durch KI-Agenten. Vor allem dort, wo hoher Effizienzgewinn mit geringem Risiko einhergeht, dürfte ihr Einsatz 2027 zunehmen. Noch spannender wird es, wenn Agenten aus ihren Erfahrungen lernen.
Anders als bei einmaligen Prompts arbeiten KI-Agenten in iterativen Schleifen. Sie bewerten Kontext und Fortschritte und passen ihr Vorgehen entsprechend an. Was passiert, wenn ein Agent eine Aufgabe 10.000-mal ausführt? Welche Erfolgsmuster lassen sich für andere Agenten ableiten? Genau hier setzen (rekursive) Selbstverbesserung und selbstlernende KI-Systeme an.
Eine Schlüsselrolle spielt zudem das Agenten-Gedächtnis (Memory). Was ein Agent gelernt hat, soll künftig auch destilliert anderen zur Verfügung stehen – sofern Zugriffsrechte und Verwendungszweck es erlauben. Graphen verknüpfen diese Erfahrungen mit ihren Quellen und ihrer temporalen Relevanz. Entscheidend sind klare Regeln für Verifizierung, Korrektur und Vergessen. Schließlich sollen Agenten aus Erfahrungen lernen, ohne jeden Fehler mit abzuspeichern, und die Essenz des Gelernten kompakt als Fähigkeiten (Skills) weitergeben.
7. KI-Governance: Prüfen, managen, kontrollieren
Während KI-Vordenker vor außer Kontrolle geratener Superintelligenz warnen, sind Unternehmen erst einmal damit beschäftigt, ihre KI-Agenten administrativ in den Griff zu bekommen. Wer kontrolliert Hunderte Agenten, die auf sensitive Daten zugreifen, Entscheidungen vorbereiten und Prozesse ausführen? Wer prüft Compliance, Sicherheitsrisiken und Kosten? Laut Gartner werden bis 2027 rund 40 Prozent der Unternehmen KI-Agenten aufgrund von Governance-Problemen zurückstufen oder außer Betrieb nehmen.
Für IT-Operations-Teams entstehen neue Aufgaben: Governance verlagert sich von der Entwicklung in den laufenden Betrieb, wo kritische Aktionen direkt überprüft werden. Bei der Observability rückt der gesamte Agenten-Workflow statt einzelner LLM-Calls in den Fokus. Denn ein Agent kann technisch fehlerfrei funktionieren und trotzdem falsche Geschäftsentscheidungen treffen. Mit Agent Fleet Management muss die IT künftig Hunderte oder Tausende Agenten mit unterschiedlichen Fähigkeiten, Versionen und Autonomiegraden verwalten.
8. KI-Ökosystem: Offen statt abgeschottet
Das KI-Ökosystem entwickelt sich überraschend offen. Statt sich mit proprietären Lösungen abzuschotten, setzen Anbieter zunehmend auf offene Protokolle, Standards und Schnittstellen. Das Model Context Protocol (MCP) hat sich in kürzester Zeit verbreitet und steht mittlerweile unter dem Dach der Linux Foundation ähnlich wird es sich beim Model Hardware Standard entwickeln. Auch bei KI-Agenten und Entwicklerplattformen gewinnt Interoperabilität vor Inkompatibilität, Agent Skills wurden auch der AI Agent Foundation übereignet.
Dahinter steckt nicht zuletzt eine gehörige Portion FOMO (Fear Of Missing Out): Wer sich abschottet, kann sich nicht mehr mit dem von Frontier Labs und der KI-Entwicklergemeinschaft vorangetriebenen KI-Ökosystem vernetzen – und umgekehrt. Diesen Ausschluss kann sich kaum ein Anbieter leisten. Weitgehend proprietär bleiben vor allem die großen KI-Modelle selbst, denen allerdings leistungsfähige Open-Weight-Alternativen zunehmend Konkurrenz machen.
9. Unternehmen in der Selbstfindungsphase
2027 müssen Unternehmen eine grundsätzliche Frage beantworten: Was wollen sie mit KI eigentlich erreichen? Wer nur auf Effizienzsteigerungen setzt, geht einen richtigen Schritt, denkt aber zu kurzfristig. Zumal mehr KI-generierter Output nicht automatisch mehr Produktivität bedeutet (Stichwort: Workslop).
Nach den massiven Investitionen in KI geht es um mehr als Kosteneinsparungen. Vorstände und Aufsichtsräte werden zunehmend fragen, wie KI das Geschäftsmodell selbst verändern kann. Welche Anwendungsfälle werden durch KI überhaupt erst möglich? Wie lässt sich Unternehmenswissen in neue Produkte und Services übersetzen? Wo schafft die eigene Expertise Wettbewerbsvorteile? Und wo eröffnen sich völlig neue Märkte?
Die „SaaSpocalypse“ zeigt die Kehrseite dieser Entwicklung. Noch ist kein Ende der Cloudanwendungen in Sicht. Doch was bleibt vom Geschäftsmodell der SaaS-Anbieter, wenn KI-Agenten Aufgaben zugeschnitten direkt über APIs erledigen? Sind SaaS-Plattformen künftig nur noch Datenbanken mit Schnittstelle? 2027 dürften Unternehmen neue Wege einschlagen, während KI-Start-ups mit neuen Ideen und Energie den Markt aufmischen. Für etablierte Unternehmen heißt es deshalb: Besser sich selbst neu erfinden, bevor es die Konkurrenz tut.
Über Neo4j
Neo4j ist die Graph-Intelligence-Plattform, die Daten in Wissen verwandelt – als Grundlage für intelligente Anwendungen und KI-Systeme der nächsten Generation. Die Plattform unterstützt Anwender, enterprise-fähige Knowledge Graphen für präzise, nachvollziehbare und kontrollierbare KI zu erstellen. Zudem liefert Neo4j umfassende, vertrauenswürdige und integrierte Graph-Funktionen, die sich unabhängig von Architektur oder Datenquelle einsetzen lassen. Die Graph-Plattform ist Teil eines einzigartigen Ökosystems, dem 84 der Fortune-100-Unternehmen vertrauen und das von der weltweit größten Graph-Community getragen wird. Erfahren Sie mehr auf www.neo4j.com.
Pressekontakt
Lucy Turpin Communications
Sabine Listl / Anja Rother
neo4j@lucyturpin.com