Die meisten KI-Modelle sind darauf trainiert, Antworten zu formulieren. Das ist hilfreich, wenn ein Mensch einen Text lesen soll. In Software entsteht daraus aber ein Umweg: Das Modell liefert Sprache, die Anwendung muss daraus erst wieder eine Entscheidung, einen Status oder eine Aktion machen. Jev von TypeSafe AI setzt an dieser Stelle an. Das Modell erzeugt keine Antworttexte, sondern bewertet einen übergebenen Zustand mit typisierten Fragen und liefert Ergebnisse, die Code direkt weiterverarbeiten kann.
Das klingt zunächst nach einer weiteren Variante von Structured Output. Der Unterschied liegt im Anspruch: Jev soll nicht erst per Prompt in ein JSON-Schema gedrückt werden. TypeSafe positioniert das Modell als „System One Model“ für schnelle, abgegrenzte Urteile. Für Teams, die Agenten, Routing oder Prüfpfade bauen, ist das vor allem eine Architekturfrage: Welche Entscheidung gehört in ein generatives Modell – und welche lässt sich als klar definierte Auswahl, Bewertung oder Wahrscheinlichkeit behandeln?
Jev beantwortet Entscheidungen statt Texte
Jev arbeitet mit einem State und mehreren Fragen. Der State kann etwa eine Support-Anfrage, ein CRM-Datensatz, ein Tool-Ergebnis oder ein Ausschnitt aus einer Agenten-Session sein. Dazu definiert die Anwendung, welche Art von Entscheidung sie braucht. TypeSafe bietet dafür drei Primitive an: Choice für eine Auswahl aus vorgegebenen Optionen, Score für eine Bewertung auf einer Skala und Noul für die Einschätzung, ob eine Aussage zutrifft.
Ein Beispiel aus dem Support: Statt ein Sprachmodell zu fragen, was ein Kunde wolle, könnte eine Anwendung parallel ermitteln lassen, ob Dringlichkeit vorliegt, welches Team zuständig ist und wie hoch die Frustration erscheint. Die Software entscheidet anschließend selbst, ob sie einen Fall direkt routet, Informationen nachfordert oder an einen Menschen übergibt. Genau diese Trennung ist relevant, wenn KI-Agenten in wiederkehrenden Abläufen nicht nur Texte erzeugen, sondern Werkzeuge auswählen und Prozessschritte auslösen sollen.
Die Fragen werden laut Dokumentation gegen denselben State parallel ausgewertet. TypeSafe verspricht dadurch wenig zusätzliche Latenz, wenn eine Anwendung mehrere unabhängige Urteile in einer Anfrage bündelt. Das Modell soll dabei nicht erklären, wie es zu einer Entscheidung kommt. Es gibt das Resultat, die Wahrscheinlichkeitsverteilung und bei Choice und Score zusätzlich einen Confidence-Wert zurück. Für Audit-Logs bleibt so sichtbar, welche Frage, welche Optionen und welche Modellversion eine nachgelagerte Route geprägt haben.
Warum das für Agenten interessant ist
In einem Agentensystem fallen viele kleine Entscheidungen an, die weder kreative Formulierungen noch lange Herleitungen benötigen: Ist ein Dokument für diesen Arbeitsschritt relevant? Welches Tool passt zu einer Anfrage? Darf ein automatisierter Vorgang fortgesetzt werden? Ist ein Ticket ein Fall für Abrechnung, Technik oder Vertrieb? Solche Entscheidungen werden oft mit einem großen Modell samt Tool-Call, Parser und Reparaturprompt umgesetzt. Das funktioniert, bringt aber Tokenkosten, variable Antwortzeiten und zusätzliche Fehlerflächen mit.
Jev verschiebt diese Ebene in einen spezialisierten Dienst. Die Anwendung liefert weiterhin Regeln und Grenzen: Bei Choice werden die erlaubten Optionen vorgegeben, bei Score die Skala beschrieben. Das Modell entscheidet innerhalb dieses Rahmens. Es kann also nicht plötzlich ein neues Team, ein unbekanntes Tool oder ein frei erfundenes Format zurückgeben. Das ist keine Garantie für die fachliche Richtigkeit der Auswahl. Es verhindert aber eine Fehlerklasse, die entsteht, wenn freie Modelltexte anschließend geparst und in Produktionslogik übersetzt werden.
Diese Idee passt zu einer Praxis, die bei produktiven Agenten ohnehin sinnvoll ist: Deterministische Fakten gehören in Code oder Datenbanken, die Bewertung eines mehrdeutigen Textes in ein Modell und risikoreiche Aktionen hinter eine klare Freigabe. Auch die Debatte um lokal laufende Agenten und ihre Infrastruktur zeigt, dass ein Agent nicht als einzelnes Modell verstanden werden sollte. Er ist ein Ablauf aus Daten, Regeln, Tools, Zuständen und Kontrollpunkten.
Confidence ist kein Freifahrtschein
Die Confidence-Angabe ist der spannendste Teil des Konzepts – und zugleich der Bereich, der am leichtesten missverstanden werden kann. Bei Choice und Score liefert Jev nicht nur den wahrscheinlichsten Wert, sondern die Verteilung über alle Optionen beziehungsweise Bewertungsstufen. Der daraus abgeleitete Confidence-Wert liegt zwischen 0 und 1. Eine konzentrierte Verteilung signalisiert, dass das Modell eine klare Tendenz sieht; eine flache Verteilung weist auf einen unklaren Fall hin.
Die richtige Reaktion darauf ist nicht, jeden hohen Wert automatisch auszuführen. TypeSafe empfiehlt selbst, Schwellenwerte nach Risiko zu definieren. Für eine harmlose Navigation im Kundenportal kann eine niedrigere Schwelle genügen. Bei einer Überweisung, einer Kündigung oder einer sicherheitsrelevanten Änderung sollte das System zusätzliche Prüfungen und eine ausdrückliche Bestätigung verlangen. Wer den Wert sinnvoll nutzen will, muss ihn deshalb mit eigenen Daten testen und die Fehlerkosten pro Aktion kennen. Die Dokumentation zu Confidence betont ausdrücklich, dass Kalibrierung Gruppen von Vorhersagen beschreibt und keine einzelne Antwort garantiert.
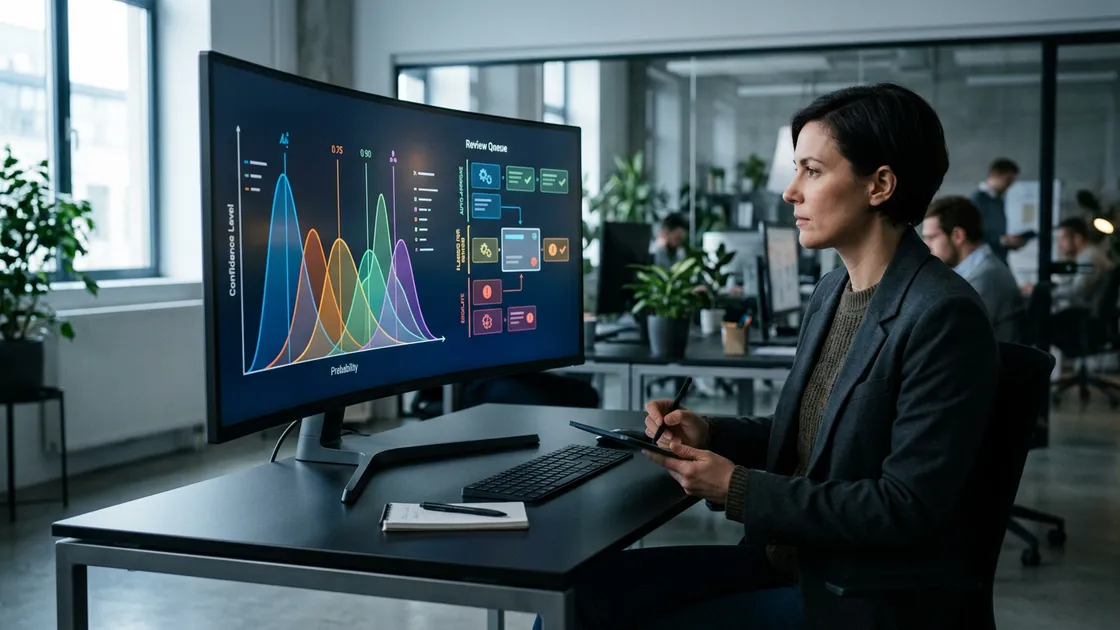 Dieses Bild wurde komplett mit KI generiertProviderHiggsfieldModellnano_banana_2PromptEditorial depiction of Jev confidence thresholds and review queue
Für Unternehmen folgt daraus ein praktisches Muster: Jev kann eine Vorentscheidung liefern, während Code harte Regeln abprüft und ein Mensch Grenzfälle übernimmt. In einer Rechnungsprüfung könnte das Modell etwa Belege als plausibel, unklar oder auffällig einordnen. Eine Zahlung wird dadurch nicht automatisch freigegeben. Das System nutzt die Einschätzung, um Standardfälle zu priorisieren und auffällige Fälle in eine nachvollziehbare Prüfung zu leiten.
Wo Jev passt – und wo nicht
Jev ist kein Ersatz für ein Sprachmodell, das E-Mails formuliert, Code schreibt, Quellen zusammenfasst oder einen komplexen Plan entwickelt. Auch für Rechenaufgaben, Suche und mehrstufiges Schlussfolgern ist das Modell nicht gedacht. TypeSafe beschreibt System One ausdrücklich als schnelle, fokussierte Beurteilung: Eine Frage sollte so eng sein, dass eine fachkundige Person sie mit dem vorliegenden Kontext zügig beantworten könnte. Breite Fragen sollen in atomare Teilentscheidungen zerlegt und anschließend im Code kombiniert werden.
Ein öffentliches, nicht von TypeSafe betriebenes Benchmark-Projekt macht diese Grenze greifbar. In einem Schachtest schnitt Jev mit einer bloßen Brettbeschreibung schwach ab; mit von Code vorbereiteten, taktischen Fakten verbesserte sich das Ergebnis deutlich. Bei der Erkennung, welche Spielfigur angesprochen wird, erreichte das Projekt dagegen hohe Werte. Die Zahlen sind wegen der kleinen Testmengen keine allgemeine Leistungszusage. Die zentrale Lektion ist dennoch belastbar: Rechnen, Suchen, zulässige Optionen und harte Regeln sollte das System deterministisch vorbereiten. Das Modell bewertet dann die mehrdeutige Entscheidung.
Das gilt auch für Sicherheit. Ein Modell kann eine verdächtige Eingabe markieren oder eine Tool-Anfrage klassifizieren. Es ersetzt keine Berechtigungsprüfung und keine Zugriffskontrolle. Wer ein Tool nur deshalb ausführt, weil ein Modell eine hohe Wahrscheinlichkeit meldet, verlagert eine Sicherheitsentscheidung in eine Komponente, die dafür nicht allein zuständig sein sollte. Bei hohen Risiken muss eine regelbasierte Kontrolle das letzte Wort behalten.
Technische Grenzen und Kosten von Jev
Aktuell nennt TypeSafe für Jev 1.13 eine Kontextlänge von 64.000 Tokens pro Anfrage. Für den State plus die längste einzelne Frage gelten 32.000 Tokens. Eingaben können Text, JSON-Objekte oder Text-Arrays sein; Bild-, Audio- und Videodaten müssen vorher in Text oder strukturierte Felder überführt werden. Das aktuelle stabile Alias jev-latest verweist laut Modellübersicht auf jev-1.13.0. Wer Confidence-Schwellen evaluiert hat, sollte für produktive Abläufe besser eine Version pinnen als sich stillschweigend auf ein bewegliches Alias zu verlassen.
Der Preis liegt laut Anbieter bei 0,042 US-Dollar pro Million Input-Tokens; Output-Tokens werden nicht berechnet. Das macht den Ansatz für viele kleine Klassifikationen attraktiv. Der Preis allein ist aber nicht die wirtschaftliche Kennzahl. Entscheidend sind auch die Kosten für Fehlrouting, Review-Aufwand, Observability und die Tests, die nötig sind, bevor eine Automation tatsächlich selbstständig handeln darf.
So sollte ein Jev-Pilot aussehen
Ein sinnvoller Einstieg beginnt nicht mit einer offenen Frage wie „Was soll der Agent als Nächstes tun?“. Besser ist ein abgegrenzter Prozess mit historischen Fällen und einer reversiblen Entscheidung. Ein Support-Team könnte zunächst nur die Zuständigkeit eingehender Tickets klassifizieren. Ein Vertriebsteam könnte Leads priorisieren, ohne automatisiert Mails zu versenden. Und ein interner Wissensassistent könnte Treffer nach Relevanz sortieren, während die Suche selbst weiter aus einem Index kommt.
Für jede Kategorie braucht das Team eine klare Definition. Welche Informationen liegen im State? Welche Optionen sind erlaubt? Was zählt als korrekte Entscheidung? Welche Fälle müssen immer in die manuelle Prüfung? Diese Vorarbeit ist weniger spektakulär als ein Agenten-Demo-Video, entscheidet aber über die spätere Qualität. Je präziser die Optionen und Kriterien beschrieben sind, desto besser lässt sich auch nachvollziehen, warum ein System einen Fall falsch zugeordnet hat.
Im nächsten Schritt sollte Jev zunächst im Schattenmodus laufen. Das Modell bewertet echte oder historische Fälle, die bestehende Bearbeitung bleibt unverändert. Anschließend lassen sich Trefferquote, Confidence-Verteilung und Fehlertypen vergleichen. Besonders aufschlussreich sind die Fälle mit hoher Confidence und falschem Resultat. Sie zeigen, ob der State wichtige Informationen vermisst, ob Kriterien unscharf sind oder ob der Anwendungsfall schlicht nicht zur Modellklasse passt.
Bei der Integration in Agenten lohnt sich außerdem eine strikte Trennung der Rollen. Ein generatives Modell kann eine Anfrage zusammenfassen, Informationen extrahieren oder einen Vorschlag formulieren. Jev kann danach eine knappe Entscheidung treffen, etwa über das passende Tool oder die Übergabe an eine Person. Harte Checks folgen im Code: Berechtigung vorhanden, Pflichtfeld ausgefüllt, Limit eingehalten, Aktion erlaubt. Der aktuelle Beitrag zur Produktionsreife von Agenten zeigt, weshalb eine bestandene Demo oder ein einzelner Eval-Wert dafür nicht genügt.
Monitoring gehört von Anfang an dazu. Pro Entscheidung sollten Teams mindestens Modellversion, Fragekonfiguration, Confidence, gewählte Option, nachgelagerte Aktion und späteres Korrektursignal erfassen. Das macht Schwellenwerte überprüfbar und schützt vor schleichenden Änderungen, wenn sich Eingabedaten oder Modellalias verändern. Personenbezogene Daten brauchen dabei dieselbe Sorgfalt wie in jedem anderen externen KI-Dienst: Datensparsamkeit, Zugriffskontrollen, Vertragsthemen und ein klarer Zweck sind keine Nebensache.
Die eigentliche Chance liegt in der klaren Aufgabenverteilung
Der Hype um Jev erklärt sich weniger durch einen neuen Chatbot als durch eine andere Idee davon, wo ein Modell im Software-Stack sitzt. Für viele Agenten-Projekte ist nicht die nächste lange Antwort der Engpass, sondern die Vielzahl kleiner, wiederholter Entscheidungen zwischen zwei Werkzeugaufrufen. Ein Modell, das dafür strukturierte Antworten, Wahrscheinlichkeiten und kontrollierte Auswahlräume liefert, kann diese Schleifen vereinfachen.
Ob daraus ein verlässliches Produkt wird, entscheidet sich nicht an einer Demo. Teams brauchen eigene Testdaten, eine Fehleranalyse je Entscheidungsklasse und klare Eskalationspfade. Jev kann dabei eine schnelle Urteilsinstanz sein. Die Verantwortung für Regeln, Berechtigungen und Konsequenzen bleibt im Anwendungscode und bei den Menschen, die den Prozess betreiben.