
Leistungsfähige KI-Modelle reichen nicht aus, wenn ihnen der passende Kontext fehlt. Context Engineering soll Informationen gezielt für den nächsten Arbeitsschritt bereitstellen – Graphdatenbanken helfen dabei, Entscheidungen und ihre Begründungen nachvollziehbar zu halten.
Wenn KI-Systemen der passende Kontext fehlt, können selbst leistungsfähige Modelle Aufgaben nicht zuverlässig ausführen. Context Engineering hilft dabei, KI-Systemen zur richtigen Zeit die nötigen Informationen bereitzustellen. Doch was ist eigentlich Kontext? Warum ist er gerade für KI-Agenten so relevant? Und welche Rolle spielen dabei Graphdatenbanken?
Die Qualität von KI-Ergebnissen hängt nicht allein vom jeweiligen Modell ab. Entscheidend ist auch der Kontext, mit dem ein Sprachmodell arbeitet – also alle Informationen, die für die Erfüllung einer Aufgabe relevant sind.
Context Engineering: Mehr als zusätzliche Inhalte
Kontext lässt sich nicht auf zusätzliche Inhalte reduzieren. Er setzt sich aus menschlichen Eingaben, Systemanweisungen, Skills, bisherigen Arbeitsschritten, Tool-Ergebnissen oder strukturierten Datenquellen zusammen. Regeln, Rollen, Prioritäten, Einschränkungen, frühere Entscheidungen oder der Verlauf einer Interaktion beeinflussen ebenfalls, wie ein Modell Inhalte einordnet und welche Antworten daraus entstehen.
Auch die Annahme, dass mehr Kontext automatisch bessere Ergebnisse bringt, greift in der Praxis häufig zu kurz. Es geht nicht um das Datenvolumen, sondern um Relevanz, Struktur und Priorisierung für die nächste Aufgabe. Sprachmodelle unterscheiden nicht automatisch zwischen wichtigen, irrelevanten oder widersprüchlichen Angaben. Sie verarbeiten Kontext zunächst als fortlaufenden Tokenstrom; selbst die Reihenfolge kann die Gewichtung einzelner Inhalte beeinflussen.
Dabei überlagern sich in realen Anwendungen mindestens drei Kontextebenen:
- Semantischer Kontext: Inhalte, Begriffe, Fakten und Definitionen.
- Operativer Kontext: Ziel, Aufgabe, Regeln und gewünschtes Ergebnis.
- Zeitlicher Kontext: Abfolge von Schritten, frühere Entscheidungen und Korrekturen.
Für Menschen ist diese Trennung meist intuitiv. Sprachmodelle gewichten Informationen hingegen nicht automatisch nach ihrer tatsächlichen Relevanz. Gerade in längeren Interaktionen oder komplexen Abläufen entstehen dadurch akkumulierte Fehlinterpretationen, Prioritätsverschiebungen oder widersprüchliche Antworten.
Fünf Kontextfallen für KI-Agenten
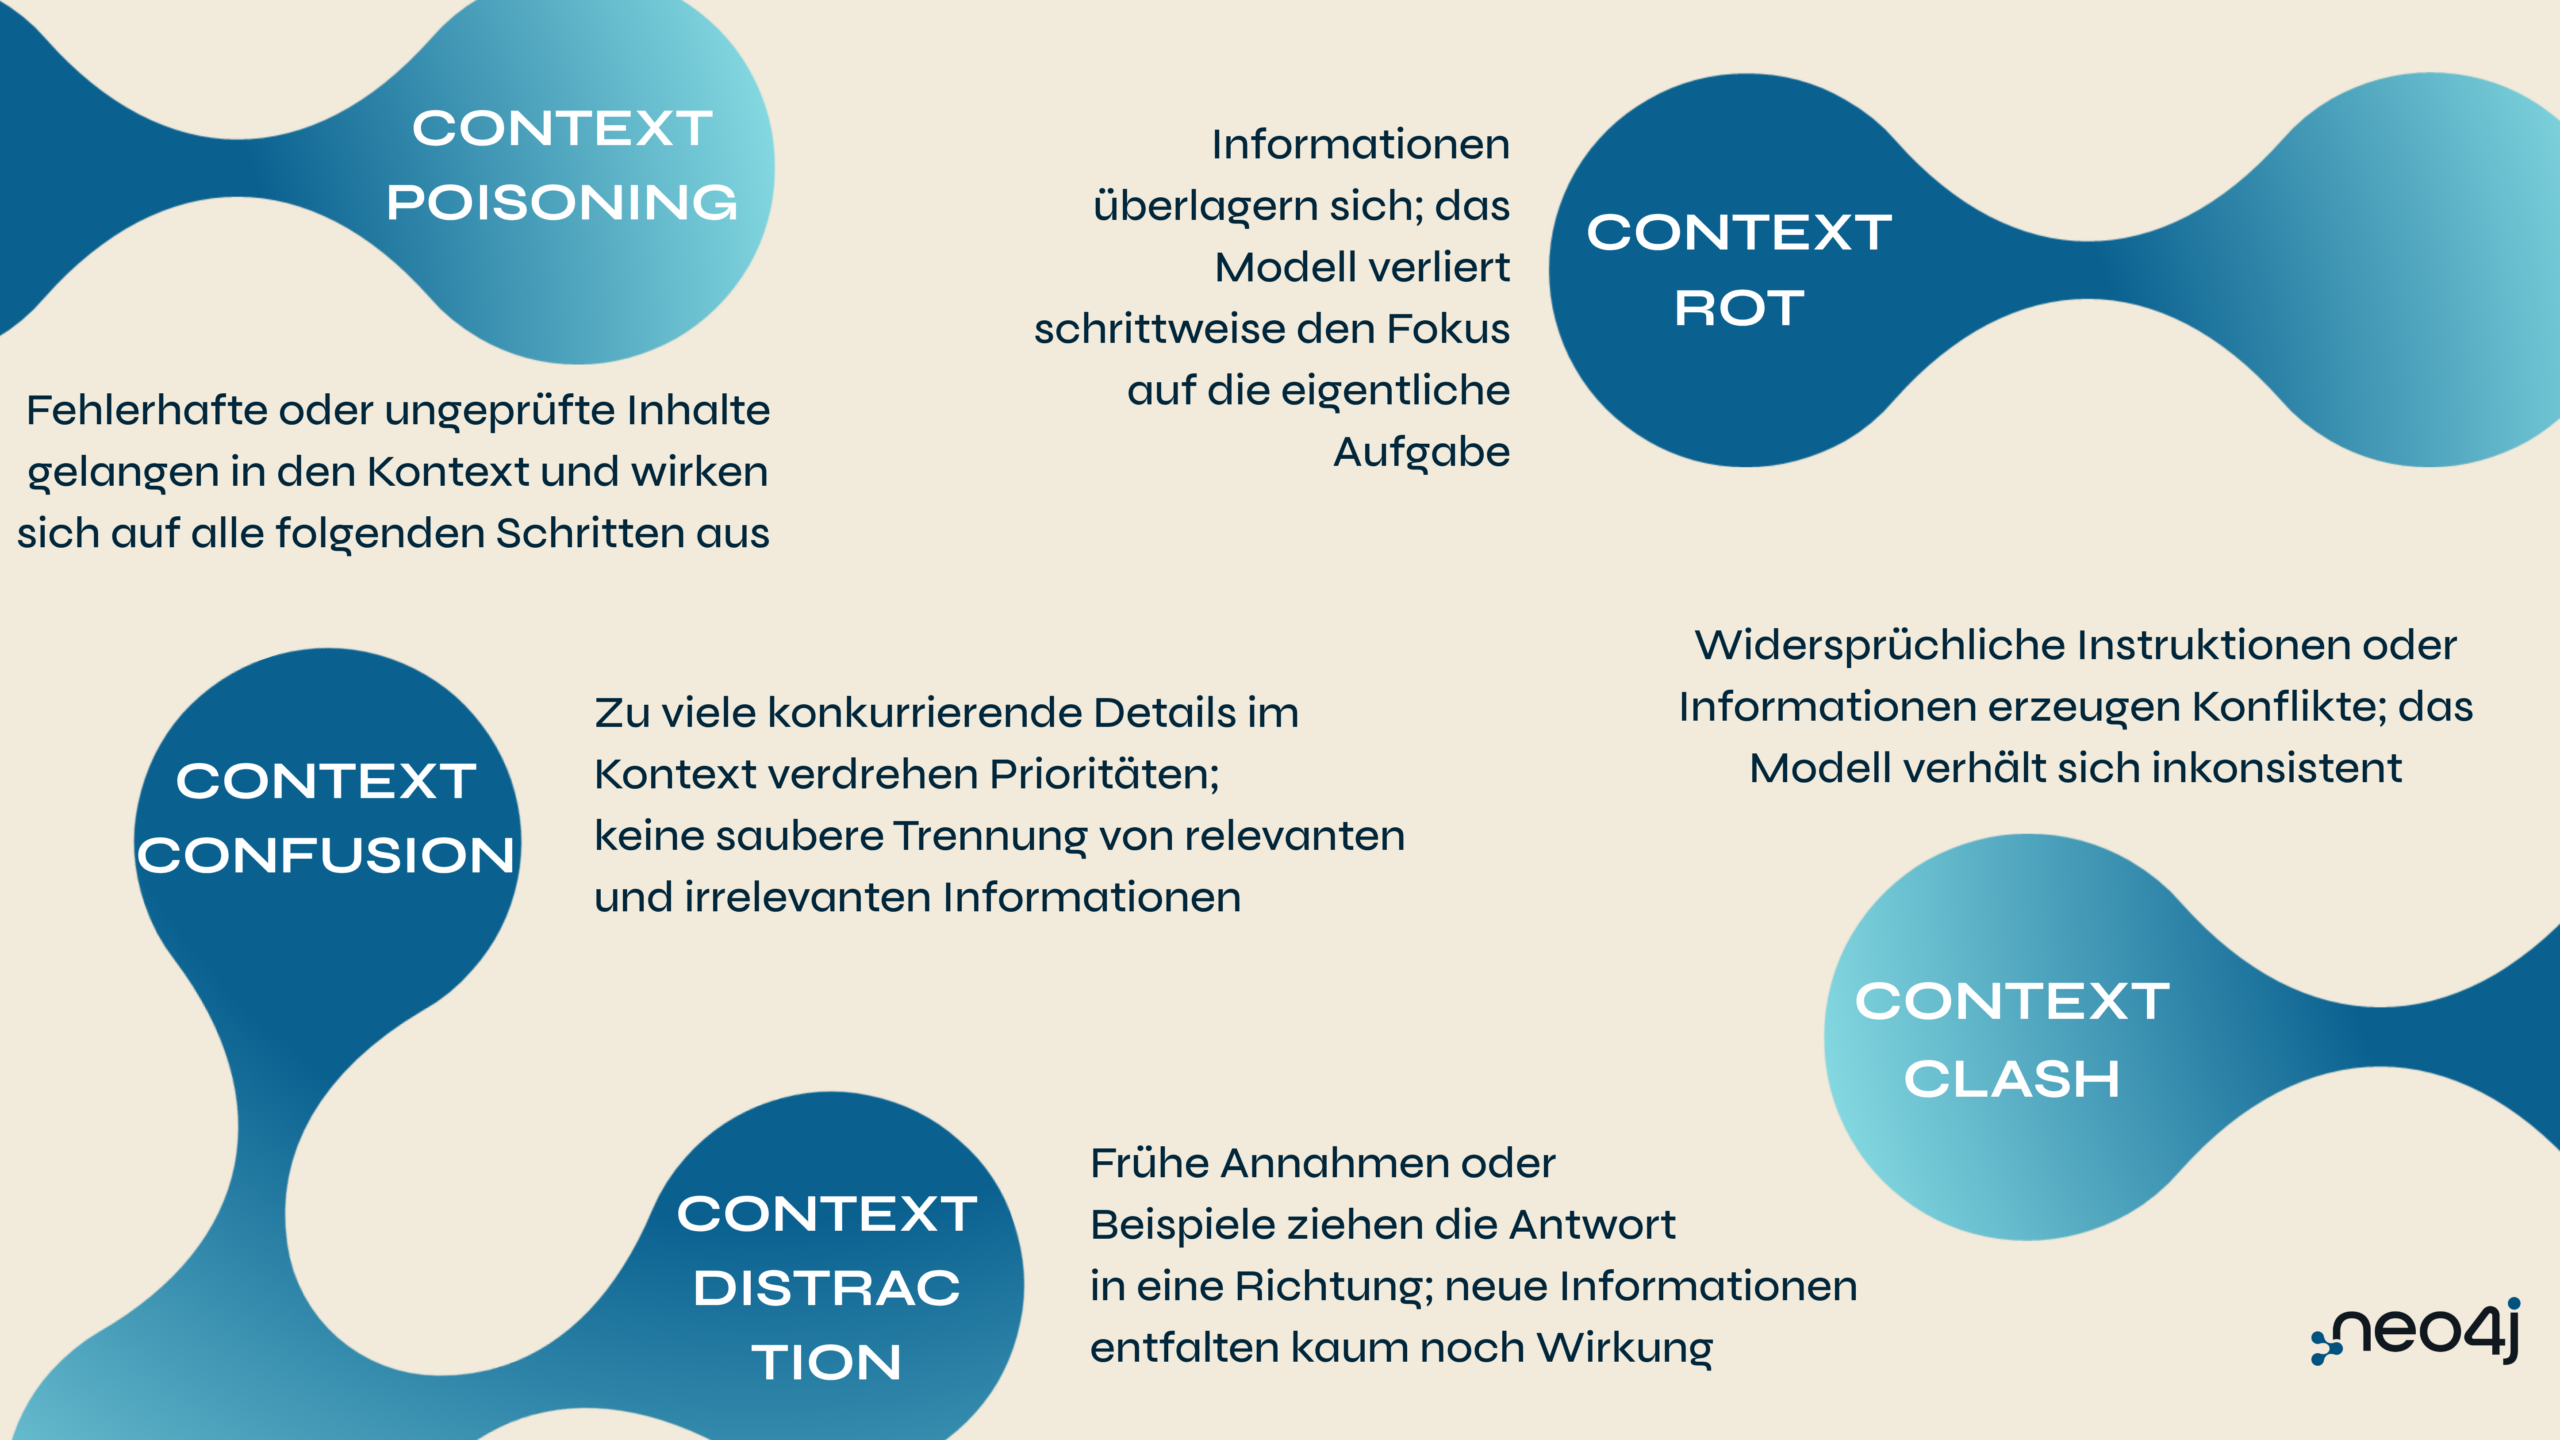
Im Kontextfenster konkurrieren Informationen permanent um Aufmerksamkeit. Irrelevante Details, frühe Annahmen oder widersprüchliche Angaben können dadurch stärkeren Einfluss auf Antworten haben als die eigentliche Aufgabe.
Context Rot: Verlust durch Überlagerung
Informationen am Anfang und am Ende werden häufig stärker berücksichtigt als Inhalte in der Mitte. Es entsteht Context Rot: Informationen wachsen an, überlagern einander und entfernen das Modell schrittweise von der ursprünglichen Zielaufgabe. Der Effekt entsteht nicht abrupt, sondern kumulativ und bleibt deshalb oft lange unbemerkt.
Context Distraction: Trägheit durch Historie
Frühe Annahmen, Beispiele oder Lösungswege beeinflussen den weiteren Verlauf überproportional stark. Neue Informationen werden zwar ergänzt, verändern das Ergebnis jedoch häufig kaum noch. Ohne eine explizite Neubewertung bleibt das Modell auf dem eingeschlagenen Pfad – auch dann, wenn sich Anforderungen verändert haben.
Context Poisoning, Confusion und Clash
Fehlerhafte oder ungeprüfte Informationen können vom Modell als Tatsache behandelt werden und nachfolgende Schritte prägen. Auch überflüssige Details beanspruchen Aufmerksamkeit und verschieben Prioritäten. Direkte Widersprüche zwischen neuen Informationen und bestehenden Vorgaben führen schließlich zu inkonsistenten Antworten.
Minimum Viable Context statt Prompt-Sammelsurium
Wer diese Fallen vermeiden will, braucht ein anderes Prinzip: den Minimum Viable Context. Ein Kontext ist für einen Arbeitsschritt vollständig, wenn er exakt die Informationen enthält, die für die nächste Entscheidung benötigt werden – nicht mehr und nicht weniger.
Das wird bei komplexeren Anwendungen wichtig. KI-Agenten planen über mehrere Schritte, treffen Entscheidungen und nutzen Werkzeuge. Über ein einziges kontinuierlich wachsendes Kontextfenster lassen sie sich nur begrenzt steuern. Sinnvoller sind Systeme, in denen Kontext gezielt aufgebaut, überprüft und für einzelne Aufgaben neu zusammengesetzt wird.
Graphdatenbanken als Wissensschicht
Sobald Kontext nicht mehr als statischer Textblock übergeben, sondern situativ konstruiert werden soll, reicht es nicht aus, Informationen einfach nur bereitzustellen. Entscheidend ist, warum eine Information in genau diesem Moment relevant ist. Klassische Datenmodelle speichern vor allem Zustände. Für KI-Agenten zählt aber auch der Weg zur Entscheidung: Welche Abwägung galt? Welche Ausnahme wurde gemacht? Wer hat etwas freigegeben – und auf welcher Grundlage?
Ein KI-System in einem Unternehmen kann so nicht nur eine Freigabe einordnen. Es erkennt auch, welche Richtlinien und Compliance-Vorgaben den Prozess bestimmt haben, an welchen früheren Fällen man sich orientiert hat und warum am Ende genau dieser Freigabeweg gewählt wurde.
Solche Entscheidungswege lassen sich nur schwer in starren Feldern oder Tabellen abbilden. Graphdatenbanken können als übergreifende Wissensschicht für KI fungieren: Sie verknüpfen nicht nur Entitäten, sondern bilden Entscheidungszusammenhänge über Zeit hinweg ab. Autonome KI-Systeme erhalten so eine operative Wissensbasis, auf der Entscheidungen nachvollziehbar und kontextbezogen getroffen werden können.
Der Punkt ist: Kontext bleibt Architekturarbeit
Künstliche Intelligenz nimmt Arbeit ab – aber nicht die Verantwortung, relevante Informationen sinnvoll auszuwählen und bereitzustellen. Je stärker KI-Agenten in Arbeitsabläufe eingebunden werden, desto mehr wird Context Engineering zu einer Aufgabe der Informations- und Systemarchitektur.