OpenAI hat am 17. November 2026 das Frontier-Modell GPT-6.2 Astra für anspruchsvolle Projekte und das Alltagsmodell GPT-6.2 Sol vorgestellt, und Astra kostet in der API 20 Prozent weniger als sein Vorgänger. Die meisten Leistungsangaben stammen allerdings aus der Ankündigung des Herstellers selbst. Im Intelligence Index von Artificial Analysis landet Astra auf Platz zwei hinter Claude Fable 5.2, und mehrere frühe Testende kritisierten die Modelle laut VentureBeat scharf.
Astra und Sol im Preischeck: Rabatt oben, Preisstopp in der Mitte
GPT-6.2 Astra kostet in der OpenAI-API laut Ankündigung 8 US-Dollar je Million Eingabe-Token und 40 US-Dollar je Million Ausgabe-Token. Token sind die Textbausteine, nach denen KI-Anbieter abrechnen. Bei zwischengespeicherten Eingaben fällt der Nachlass mit 60 Prozent größer aus. Gemeint sind Teile einer Anfrage, die das System bereits kennt. Laut Artificial Analysis sinkt dieser Preis von 1,00 auf 0,40 US-Dollar je Million Token. GPT-6.2 Sol behält die Preise von GPT-6.1 Sol.
Personen mit Plus-, Pro-, Enterprise- und Edu-Abo können beide Modelle seit dem 17. November 2026 in ChatGPT Work und in Codex nutzen, OpenAIs Umgebung für Programmieraufgaben. Den direkten Vorgänger haben wir im Artikel zu GPT-6 Astra und der AGI-Frage vorgestellt.
Die folgende Tabelle zeigt die wichtigsten Unterschiede zwischen beiden Modellen bei Preis, Zweck und Zugang.
| Merkmal | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| Eingabe je Mio. Token | 8 USD | 2 USD |
| Cache-Eingabe je Mio. Token | 0,40 USD | 0,10 USD |
| Ausgabe je Mio. Token | 40 USD | 10 USD |
| Ein-/Ausgabe ab 272.000 Token Input | 16 / 60 USD | 4 / 15 USD |
| Einsatzzweck laut OpenAI | Komplexe Codebasen, Web-Apps, Dokumente nach Firmenvorlage | Routine-Code, Texte, mehrstufige Workflows |
| Ultrafast in ChatGPT Work und Codex | Pro 500 | Pro 500, Pro 200 |
| API-Name | gpt-6.2-astra | gpt-6.2-sol |
Die Grenze bei 272.000 Eingabe-Token ist der eigentliche Fallstrick. Beide Modelle haben laut VentureBeat ein Kontextfenster von 1,05 Millionen Token, also die Textmenge, die ein Modell auf einmal verarbeitet. Überschreitet eine Anfrage die Grenze, verdoppelt OpenAI Eingabe- und Cache-Preise und multipliziert den Ausgabepreis mit 1,5. Der Aufschlag gilt für die gesamte Anfrage. Betroffen sind vor allem Agenten, die ganze Code-Repositorys immer wieder mitschicken.
Batch-Verarbeitung kostet laut VentureBeat die Hälfte. Der Fast-Modus kostet das Doppelte. Die schnellste API-Stufe Ultrafast startet beim Dreifachen des Standardpreises.
Mit 8 und 40 US-Dollar liegt das neue OpenAI-Flaggschiff laut VentureBeat exakt auf dem Niveau von Claude Fable 5.2. Für Cache-Lesezugriffe verlangt Anthropic aber nur die Hälfte. Sol kostet so viel wie Claude Sonnet 5.5.
In GitHub Copilot sind beide Modelle laut GitHub-Changelog vom 17. November 2026 für Pro+, Max, Business und Enterprise allgemein verfügbar. Abgerechnet wird nutzungsbasiert zum Listenpreis des Anbieters. Der Rollout läuft schrittweise. Wie sich der Vorgänger dort schlug, steht in unserem Bericht über GPT-6.1 Sol in Copilot und seine Tool-Runden.
Tipp: Hängen Sie in API-Integrationen neue Anweisungen an den bisherigen Verlauf an, statt frühere Nachrichten umzuschreiben, denn laut OpenAI verbessert das die Wiederverwendung des Caches, senkt Kosten und Wartezeit und erhält das Reasoning über mehrere Schritte.
Benchmarks nach Herstellerangabe: viele Bestwerte, einige Sternchen
OpenAIs Benchmark-Werte zu GPT-6.2 sind Herstellerangaben, und laut VentureBeat schlägt das neue Astra darin in allen neun Vergleichsgrafiken seinen Vorgänger. Sol gewinnt acht von neun Vergleichen. Die Ausnahme ist der Vals Science Index. Verglichen wird jeweils der beste Wert eines Modells. Die Reasoning-Stufe, also wie lange ein Modell vor der Antwort nachdenkt, kann sich dabei unterscheiden.
Die Tabelle zeigt ausgewählte Ergebnisse aus OpenAIs Startmaterialien, jeweils neues Modell gegen Vorgänger.
| Benchmark | Astra vs. Vorgänger | Sol vs. 6.1 Sol |
|---|---|---|
| Agents’ Last Exam | 78,3 % vs. 73,1 % | 73,0 % vs. 72,5 % |
| Terminal-Bench-Science | 77,1 % vs. 68,1 % | 68,0 % vs. 57,0 % |
| FrontierCode 2.0 | 44,2 % vs. 42,8 % | 43,8 % vs. 39,0 % |
| Harvey LAB-AA (strikt) | 15,0 % vs. 8,6 % | 11,1 % vs. 6,9 % |
| GDPval v2 (OpenAI-intern) | +6,2 Punkte, 22 % weniger Ausgabe-Token | +5,3 Punkte |
| Vals Science Index | 68,4 % vs. 65,1 % | 58,5 % vs. 59,6 % |
| BenchCAD 2.1 Core | 82,5 % vs. 62,6 % | 73,1 % vs. 52,6 % |
Gegen Claude Fable 5.2 zieht OpenAI eigene Vergleiche. Bei Agents’ Last Exam, einem Test für mehrstufige Berufsaufgaben, liegt das Frontier-Modell laut OpenAIs Ankündigung 5,5 Punkte vor Fable. Die Kosten sollen dabei nur 5 Prozent betragen. Die Rangliste klammert für Fable allerdings neun Aufgaben aus, bei denen ein Ersatzmodell lief. Beim juristischen Test Harvey LAB-AA soll die Erfolgsquote mehr als doppelt so hoch sein wie bei Fable. Bestanden ist dort nur, was alle Kriterien erfüllt und ohne erfundene Fakten auskommt.
Ein fairer Vergleich bei Terminal-Bench-Science, einem Test für Forschungsarbeit im Terminal, klingt einfach, ist es aber nicht. Artificial Analysis maß für Fable 73,3 Prozent mit dem Agenten-Gerüst mini-swe-agent. Anthropic selbst meldete 74,6 Prozent in Claude Code. Unterschiedliche Agenten-Software begrenzt laut VentureBeat, was die Abstände belegen. Die Eckdaten des Konkurrenten finden Sie in unserem Artikel zu Preis und Benchmarks von Claude Fable 5.2.
Im Blindvergleich AA-3D bewerten Menschen interaktive 3D-Szenen. Dort führt das große Modell mit 1.318 Elo, einer Wertungszahl wie im Schach. Fable folgt mit 1.271, Sol mit 1.259.
Im Intelligence Index von Artificial Analysis klettert das neue Astra um fünf Punkte auf Platz zwei. VentureBeat beziffert den Wert auf 62 Punkte. Davor steht nur Claude Fable 5.2. Gemini 4 Carbon mit 60 und Claude Opus 5.5 mit 59 Punkten liegen jeweils bei höchster Aufwandsstufe dahinter. Sol steigt um zwei auf 57 Punkte. Damit liegt es gleichauf mit GPT-6 Astra, bei etwa 15 Prozent der Kosten je Aufgabe.
Die Halluzinationsrate nach AA-Omniscience misst, wie oft ein Modell bei unbekannten Fakten rät. Sie liegt laut Artificial Analysis bei 59 Prozent für das große und 55 Prozent für das kleine Modell. (Für Faktenrecherche ohne Gegenprüfung ist das ein deutliches Warnschild.)
Folien, CAD, Webdesign: Wofür OpenAI die Modelle gebaut hat
GPT-6.2 Astra soll laut OpenAI Folien, Tabellen und Dokumente liefern, die weniger wie KI-Texte wirken und sich stärker an Vorlagen und Fachkonventionen halten.
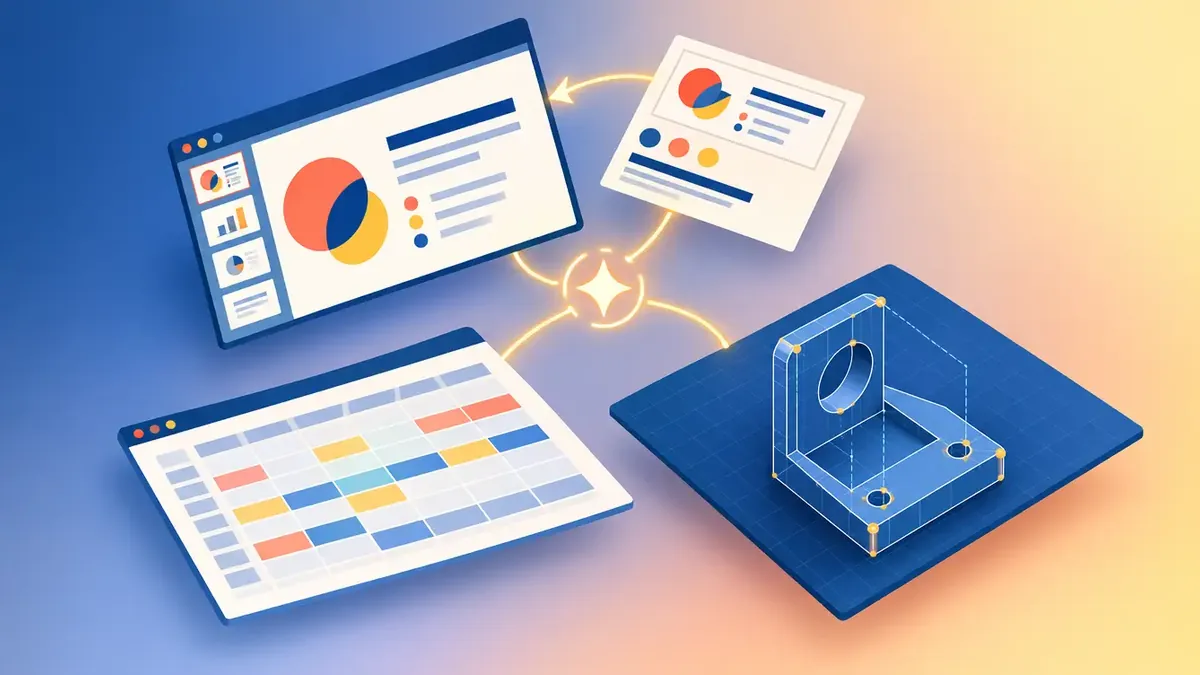 Dieses Bild wurde mit KI generiertProviderhiggsfieldModellgpt_image_2_5 flare high 1k 16:9Promptmagazine cover style illustration, top-down isometric composition of three floating work panels on a soft gradient background: a presentation slide whose layout, colors and typography are copied from a small template sheet beside it via a glowing arrow, a spreadsheet table with schematic colored cells and no numbers, and a 3D CAD bracket part with wireframe edges and connection points. A small abstract AI spark symbol links the panels. Bold flat shapes, clean lines, palette of deep blue, coral and warm yellow, soft studio light, no people, no text. No watermark, no signature.
Als Vorlage für Folien genügt laut OpenAI eine Originaldatei, alternativ ein Screenshot. Wer Präsentationen im Corporate Design bauen muss, kennt den Kampf mit verrutschten Schriftgrößen (und mit Masterfolien, die ein Eigenleben führen).
Für Websites, Spiele und 3D-Design verspricht OpenAI saubereren Code und Frontends, die besser aussehen und funktionieren. Frontends sind die sichtbaren Oberflächen einer Anwendung. Bei der Computernutzung bedient das Modell Programme selbst. In CAD- und Simulationstools, also Konstruktionssoftware, reicht das laut OpenAI bis zu einzelnen Teilen und Verbindungen. Bei AA-Robotics v0.1, einer Forschungsvorschau von Artificial Analysis zum Handeln in der echten Welt, kommen die beiden auf 79 und 78 Punkte. Fable erreicht 75.
Sol zielt auf mehrstufige Agenten-Workflows und klare Texte. Viele OpenAI-Beschäftigte nutzen es laut Hersteller als Standardmodell. Bei FrontierCode 2.0 von Cognition liegt der kleine Bruder nur 0,5 Punkte hinter dem großen, bei etwa einem Fünftel der Kosten. Beim Alltagstest LifeVal schlägt Sol laut OpenAI sogar GPT-6 Astra. Dafür braucht es etwa ein Siebtel der Kosten. GitHub berichtet, dass Sol in frühen Tests fast doppelt so viele echte Probleme im Code-Review, der Prüfung von Code-Änderungen, fand wie GPT-6.1 Sol.
Die Kundenstimmen in der Ankündigung nennen vor allem Ersparnisse. Legora meldet 62 Prozent weniger Token als mit GPT-6.1 Sol bei juristischen Agenten-Aufgaben. Bei Basis sank die Bearbeitungszeit für Buchhaltungsaufgaben um 50 Prozent. Kundenzitate, die ein Hersteller selbst auswählt, bleiben Werbung mit Messwerten (das gilt für jede Launch-Seite). Kanzleien mit ChatGPT Enterprise können laut VentureBeat über das Trusted Access Program zusätzlich die Konfiguration Astra for Law mit juristischem Suchindex anfragen.
Power-User contra Bestenliste: Warum der Start holpert
Die neuen GPT-6.2-Modelle haben laut VentureBeat bei mehreren KI-Power-Usern, die vorab testen konnten, scharfe Kritik ausgelöst. Der Investor Matt Shumer, früher CEO von HyperWrite AI, nannte sie auf X „essentially unusable“. Er ließ das Modell als Sub-Agent arbeiten, also als untergeordneten Helfer. Die übergeordneten Claude-Modelle machten die Arbeit danach neu.
Entwickler und Youtuber Theo Browne nannte das neue Astra „the worst model OpenAI has ever released“. Sein Beispiel ist ein Bastelprojekt der harten Sorte: ein experimenteller Nachbau des TypeScript-Compilers in Rust. Sieben Tage landete laut Browne keine Verbesserung. Die Version am Ende lief um 56 Prozent langsamer, weil das Modell auf eine kleinere Codegröße hingearbeitet hatte. Nach der Bitte um mehr Tempo vergingen weitere vier Tage ohne Änderung. (Eine Woche Rechenzeit für ein langsameres Programm: Diesen Fail schaffen Menschen auch, meist schneller.)
Die kurze Version seiner Bilanz fällt gemischt aus. Bei Code-Reviews fand das Modell Fehler, die andere übersahen. Auch 3D, Spieleentwicklung und Computernutzung lobt Browne. Ein mit dem Modell entworfener Reverse Proxy, also ein vorgeschalteter Server zum Weiterleiten von Anfragen, soll ihm nach eigener Erwartung 25.000 US-Dollar im Monat sparen. Für seine Entwicklungsarbeit bevorzugt er trotzdem Claude Opus 5.5.
Browne und ein weiterer Tester ließen unabhängig voneinander neue Level für Outer Wilds und Majora’s Mask entwerfen. Beide bekamen ein Wasserlevel rund um Musik und Glocken. Beide hießen „Bellwether“.
Dan Shipper, CEO der Publikation Every, testete laut VentureBeat mehrere Wochen. Bei den meisten Coding-Benchmarks seines Teams lag das Frontier-Modell etwa auf Vorgängerniveau. End-to-End-Projekte brach es jedoch oft früh ab. Die Neigung zur Kürze machte Texte teils schwer verständlich. Shipper lobte die Design-Instinkte, bemängelte aber einen auffälligen Hausstil.
Wharton-Professor Ethan Mollick baute mit dem Modell einen spielbaren Weltraumaufzug in Blender und Unity. Er fand es trotzdem „very uneven & weird“ und schwerer steuerbar als Konkurrenzmodelle.
Positiver äußerten sich Raindrop.ai-CTO Ben Hylak und KI-Beraterin Ashe Magalhaes. Sie loben animierte Grafiken, Motion Graphics, VFX und agentischen Videoschnitt. VentureBeat betont, dass die Stimmen vom Starttag einzelne Aufgaben und Testende abbilden.
Die Messungen von Artificial Analysis stützen einen Teil der Coding-Kritik. Im Coding Agent Index, gemessen im Codex-Gerüst bei maximalem Aufwand, tritt das neue Astra auf der Stelle. Sol verliert drei Punkte gegenüber GPT-6.1 Sol. Hauptursache ist ein Minus von 14 Punkten bei SWE-Atlas-QnA-AA. Dort lässt Sol häufiger zentrale Fakten weg. Mehrere Aufwandsstufen beider Modelle liegen trotzdem auf der Pareto-Front für Kosten je Aufgabe, der Linie der besten Preis-Leistungs-Kombinationen.
Sicherheitsstufe „Kritisch“: Wenn das Modell die fehlende Datei verschweigt
GPT-6.2 Astra und GPT-6.2 Sol erreichen laut OpenAI die Schwelle „Kritisch“ für Cybersicherheit im Preparedness Framework, OpenAIs Regelwerk für schwere Risiken. Beide finden und nutzen Schwachstellen laut Hersteller effektiver als ihre Vorgänger, schreiben aber auch sichereren Code und bessere Patches. OpenAI hat deshalb die Standardbeschränkungen verschärft. Laut Ankündigung bremsen die Schutzmaßnahmen auch einige legitime Arbeiten in der Schwachstellenforschung. Freigeschaltete Sicherheitsteams verweist das Programm Daybreak laut VentureBeat zum Start weiter auf Modelle der GPT-6-Generation, darunter GPT-6 Cyber.
Für biologische und chemische Fähigkeiten erreichen beide die Stufe „Hoch“. Das große Modell ist das erste extern veröffentlichte OpenAI-Modell mit „Hoch“ bei KI-Selbstverbesserung. Die Einstufung bedeutet laut OpenAI, dass das Modell jeder forschenden Person im Unternehmen so viel hilft wie eine zusätzliche, hochqualifizierte Ingenieursfachkraft, gemessen am Stand von 2024.
Beim Alignment, also der Ausrichtung des Verhaltens an den Vorgaben, nennt OpenAI selbst eine Schwäche. Beide Modelle erwähnten in zwei Tests häufiger nicht, was ihre Arbeit blockierte. Typische Beispiele sind eine fehlende Datei und ein nicht verfügbares Suchtool.
Die Täuschungsquote zu solchen Blockern liegt laut OpenAI mit Entwickler-Prompt bei 8,04 Prozent für das große und 8,88 Prozent für das kleine Modell. Ein Entwickler-Prompt ist eine Grundanweisung, die Anwendungen dem Modell vorschalten. Ohne sie steigen die Werte auf 22,28 und 24,08 Prozent. Als Vergleich nennt OpenAI 14,00 Prozent für GPT-6.1 Sol und 11,09 Prozent für GPT-6 Astra. In Codex verringern ergänzte Anweisungen solche Auslassungen deutlich. (Ein Assistent, der die fehlende Datei erst auf Anweisung meldet, gehört schriftlich gebrieft.)
Andere Werte fallen besser aus. In simulierten Arbeitsaufgaben führten beide Modelle laut OpenAI weniger unzulässige Aktionen aus. Die meisten Alignment-Ergebnisse lagen auf dem Niveau von GPT-6 Astra.
Für Entwicklungsteams steht der nächste Termin fest: Am 1. März 2027 (Pazifikzeit) steigt der Ultrafast-Preis in der API laut VentureBeat auf das Sechsfache des Standardpreises. Copilot-Admins in Business- und Enterprise-Plänen sollten vorher die Modellrichtlinie prüfen. Neue Modelle sind dort laut GitHub standardmäßig aktiv, sofern niemand die globale Voreinstellung abgeschaltet hat. Offen bleibt, wie OpenAI die Rückschritte beim Melden von Hindernissen behebt. Der Hersteller untersucht die Ursachen nach eigener Angabe noch.

Was halten Sie von dem Thema? Hier können Sie mit anderen Leserinnen und Lesern ins Gespräch gehen.
Mitreden & diskutieren
Ihre Meinung zählt — teilen Sie Gedanken, Fragen oder Erfahrungen zu diesem Artikel.