
OpenAI hat am 10. September 2026 die Agents API in die öffentliche Testphase (Public Beta) geschickt. Laut der Einführung des Unternehmens bringt sie denselben Harness an Entwickler, der auch Codex trägt, also ein gemanagtes Steuerungsgerüst mit Sitzungen, Orchestrierung und Wiederaufnahme. Unternehmen sollten ihre Agenten deshalb als betriebene Systeme führen und nicht als immer längere Folge von Prompts.
Harness bezeichnet hier die Schicht, die Laufzeit, Kontext, Wiederaufnahme und Umgebung vom Prompt trennt. Dazu gehören Sitzungen (Sessions), die Verdichtung des Kontexts, die Wiederaufnahme nach Fehlern (Recovery), abgeschottete Ausführungsumgebungen (Sandbox) und Unteragenten (Subagents). Der Artikel erklärt, was die Schnittstelle liefert, was die Kundenzahlen taugen und welche Lücken bei der Datenhaltung bleiben.
Prompt-Ketten verlieren im Betrieb die Kontrolle
Prompt-Ketten skalieren nicht, weil sie Instruktionen aufeinanderstapeln, bis niemand mehr sagen kann, wer wann welches Werkzeug nutzen darf. Wer Produktion wie ein Chat-Experiment baut, bekommt Chat-Experimente in der Kostenstelle.
Die Versuchung ist alt: ein überlanger Prompt, drei verkettete Aufrufe, ein Werkzeugaufruf ohne klare Regel und die Hoffnung, dass das Modell die Reihenfolge hält. Im ersten Sprint fühlt sich das nach Tempo an. Nach zwölf Monaten bleiben Ketten, die niemand erklären kann, Wiederholungsversuche ohne Sitzungskennung und Kontextfenster, die volllaufen, bis die Antworten abdriften. Prompt-Ketten brechen dabei an fünf Stellen, die ein Harness adressiert:
- Zustand: Ketten rekonstruieren den Kontext oft von Hand, Sitzungen behalten die Arbeit über mehrere Runden.
- Kontextfenster: Ketten quellen über, während das Verdichten früheren Kontexts Aufgabe des Harness ist und kein Kopieren in den nächsten Prompt.
- Fehler: Ketten enden mit der Anfrage, Wiederaufnahme leistet der Harness.
- Parallelität: Unteragenten ohne Beobachtung erzeugen Chaos, mit Orchestrierung über die Schnittstelle werden sie zur Arbeitsteilung.
- Umgebung: Ketten rufen Werkzeuge auf, der Harness bindet dagegen Ausführungsumgebung, Skills, MCP-Server (Model Context Protocol) und Grenzen.
Hinzu kommt ein organisatorisches Problem. Prompt-Ketten liegen häufig in einem Ordner, den drei Personen kennen und für den niemand verantwortlich ist. Programmierschnittstellen mit Sitzungen erzwingen wenigstens Kennungen, Ereignisse und löschbare Sitzungen. Das schafft keine gute Steuerung, macht schlechte aber sichtbar, und Sichtbarkeit ist die Voraussetzung jeder Prüfung. Wer die Kette besitzt, besitzt oft nur Dateien. Wer die Sitzung besitzt, besitzt die Laufzeit: Er weiß, wer startet, wer steuert, wer löscht und wer die Rechnung sieht.
Dieselbe Disziplin zeigt der Agentforce-Workflow mit Ticket-Übergabe auf einem anderen Technikstapel. Die Übergabe an Menschen ist dort eine Grenze, die vor dem Start gesetzt wird, damit nicht am Ende der Agent alles erledigt und nichts mehr nachvollziehbar bleibt. Den gleichen Druck gibt es bei Unternehmenssoftware: Wer das Zugangstor zu den Abläufen kontrolliert, steuert sie, wer nur Prompts kontrolliert, verwaltet Textbausteine. Mehr dazu steht im Beitrag über ERP-Agenten-Zugang, Copilot und Joule-Workflows.
Die Nachricht hinter der Veröffentlichung ist, dass OpenAI Unternehmensagenten als Betriebstechnik anbietet und nicht als Versprechen eines einzigen Superprompts.
Public Beta bedeutet, dass der Harness erreichbar ist. Ob ein Unternehmen ihn nutzt, bleibt seine Wahl. Wer weiter Ketten pflegt, wählt trotzdem etwas, nämlich Betriebsrisiko als Standard.
Der gemanagte Harness übernimmt Sitzungen, Verdichtung und Wiederaufnahme
Laut der Einführung von OpenAI vom 10. September 2026 steht die Agents API in der Public Beta bereit und liefert Harness und Infrastruktur von Codex über eine einfache, flexible Schnittstelle. OpenAI verwaltet dabei Sitzungen, Orchestrierung, Kontextverdichtung und Wiederaufnahme. Die eigene Anwendung liefert die Werkzeuge und wählt die Ausführungsumgebung.
Die Entwicklerdokumentation stützt die Schnittstelle auf vier Begriffe:
- Agent: Modell, Instruktionen, Werkzeuge und MCP-Server, die dem Agenten zur Verfügung stehen.
- Umgebung (Environment): eine optionale Sandbox oder ein Computer, in dem der Agent Dateien, Skills und Befehle nutzt.
- Sitzung: eine dauerhafte Instanz eines Agenten, die Aufgaben bearbeitet und auf Eingaben reagiert.
- Ereignisse und Elemente (Events und Items): Eingaben an den Agenten und Ausgaben, die während einer Sitzung entstehen.
Eine Sitzung bedeutet, dass der Zustand erhalten bleibt. Die Anwendung startet sie, gibt eine Aufgabe, verfolgt den Fortschritt per Stream oder Webhook, steuert nach oder setzt die Arbeit fort. Bei einer von OpenAI gehosteten Sitzung schickt die Anwendung Eingaben und empfängt Ereignisse, während OpenAI Agent und Sandbox betreibt. Das unterscheidet Orchestrierung von bloßer Hoffnung auf den nächsten Prompt.
Der gemanagte Harness unterstützt laut Dokumentation unter anderem Befehle und Code in der Sandbox, Skills und Instruktionen, externe Daten über Werkzeuge oder MCP sowie Steuerung während der Arbeit. Hinzu kommen das Zusammenfassen früheren Kontexts, das Zerlegen in Teilaufgaben mit Delegation an Unteragenten und die Wiederaufnahme dort, wo die Sitzung stand. Die Sandbox lässt sich bei OpenAI hosten oder selbst betreiben. Der Selbstbetrieb gibt Kontrolle über den Arbeitsbereich und die Verzeichnisse für Fähigkeiten (Capability-Directories).
Beim Preis nennt OpenAI in der Einführung keine zusätzlichen Gebühren für die Agents API. Bezahlt werden Tokens und Werkzeuge, wie auf der Preisseite beschrieben. Die Dokumentation präzisiert: Die Modellnutzung kostet die API-Raten des gewählten Modells, OpenAI-Werkzeuge kosten ihre Standardraten, gehostete Sandboxes die Standardraten für Container. Das sind Herstellerangaben und keine unabhängige Studie zu den Gesamtkosten. Container, Werkzeuge und Tokens sollten getrennt gerechnet werden, denn keine zusätzliche Gebühr bedeutet keinen kostenlosen Betrieb.
Die Beispiele der Dokumentation reichen von der Störfallbearbeitung mit Freigabe über einen Slack-Bot mit Arbeitsplatzwerkzeugen bis zum Datenanalysten mit reinem Lesezugriff auf SQL. Genannt werden außerdem ein Untersucher für GitHub-Issues und ein Dokumentenprüfer mit Regel-Skills. Das sind Nutzungsskizzen und keine Zusage für das eigene Ticketsystem, aber sie taugen als Checkliste. Braucht ein Fall Freigaben, Lesezugriff, Skills oder Unteragenten, gehört das in die Sitzungskonfiguration und nicht in einen Systemprompt mit 4.000 Token.
Auch Open-Source-Frameworks orchestrieren Agenten. Der Unterschied liegt darin, wer Verdichtung, Wiederaufnahme und den Lebenszyklus der Sitzung trägt. Eine Einordnung liefert der Beitrag über Open-Source-Agenten im Unternehmen mit LangChain und LlamaIndex. Ein Eigenbau kann passen, braucht aber dieselbe Disziplin. Ein gemanagter Harness nimmt Teams die Erfindung von Sitzung, Verdichtung und Wiederaufnahme ab, nicht aber die Festlegung von Werkzeugen, MCP-Servern, Zulassungslisten und Fachrollen.
Am 8. September 2026 wurde zudem GPT-6 Astra auf Amazon Bedrock allgemein verfügbar. Für Agenten-Teams sind Modellwahl und Harness-Wahl jedoch zwei getrennte Entscheidungen.
Die Kundenzahlen aus der Einführung sind ohne Methodik nicht belastbar
OpenAI zitiert in der Einführung Kunden, deren Zahlen als Herstellerangaben ohne veröffentlichte Methodik zu lesen sind. Es gibt keine unabhängigen Vergleichstests, keine Begutachtung durch Fachkollegen und kein gemeinsames Testprotokoll. Genannt werden drei Aussagen:
- Ciridae (Jack Weissenberger, Technikchef): Der Bewertungswert stieg von 0,71 auf 0,85. Die Unterstützung von Unteragenten habe den Arbeitsablauf stark beschleunigt, weil Beobachtung und Orchestrierung zuvor umständlich gewesen seien. Die neuen Schnittstellen hätten die Latenz auf ein Viertel gesenkt.
- SafetyKit (Bhavyansh Sabharwal): Nach der Migration des Arbeitsablaufs für die Prüfung von Fällen sanken die Kosten pro Fall um 60 Prozent. Dazu kamen niedrigere Latenz und bessere Token-Effizienz bei gleichbleibender Leistung.
- Hypha (Serhii Shchoholiev): Durch die Trennung von Agent-Harness und Sandbox gab es 86 Prozent weniger fehlgeschlagene Agentenantworten.
Als Richtungshinweise sind die Aussagen brauchbar, denn sie betonen Unteragenten, sparsamen Umgang mit Tokens und die Trennung von Harness und Sandbox. Als Entscheidungsgrundlage taugen sie ohne eigene Messung nicht. Die Kosten pro Fall hängen vom Ausgangswert, vom Werkzeugmix und von den Sandbox-Kosten ab, und ohne Methodik bleibt die Zahl Werbung mit Prozentzeichen. Wer die Werte in eine Vorstandspräsentation kopiert und die Herkunft streicht, betreibt keine Sorgfaltsprüfung.
Sinnvoll ist ein eigenes Bewertungsverfahren mit wiederholbaren Fällen, Bewertungswerten, Prüfung auf Rückschritte und Zählung der fehlgeschlagenen Antworten. Erst dann gibt es Zahlen, die ein Team selbst verantworten kann. Das gilt auch für die Ciridae-Werte, denn sie betreffen genau ein solches Bewertungsverfahren.
Datenresidenz nur in den USA: Ein selbst betriebener Sandkasten ändert daran nichts
Laut der Dokumentation unterstützt die Agents API Datenresidenz, also die Wahl des Speicherorts, derzeit nur in den USA. Zero Data Retention (ZDR), die Null-Speicherung von Daten, wird nicht unterstützt.
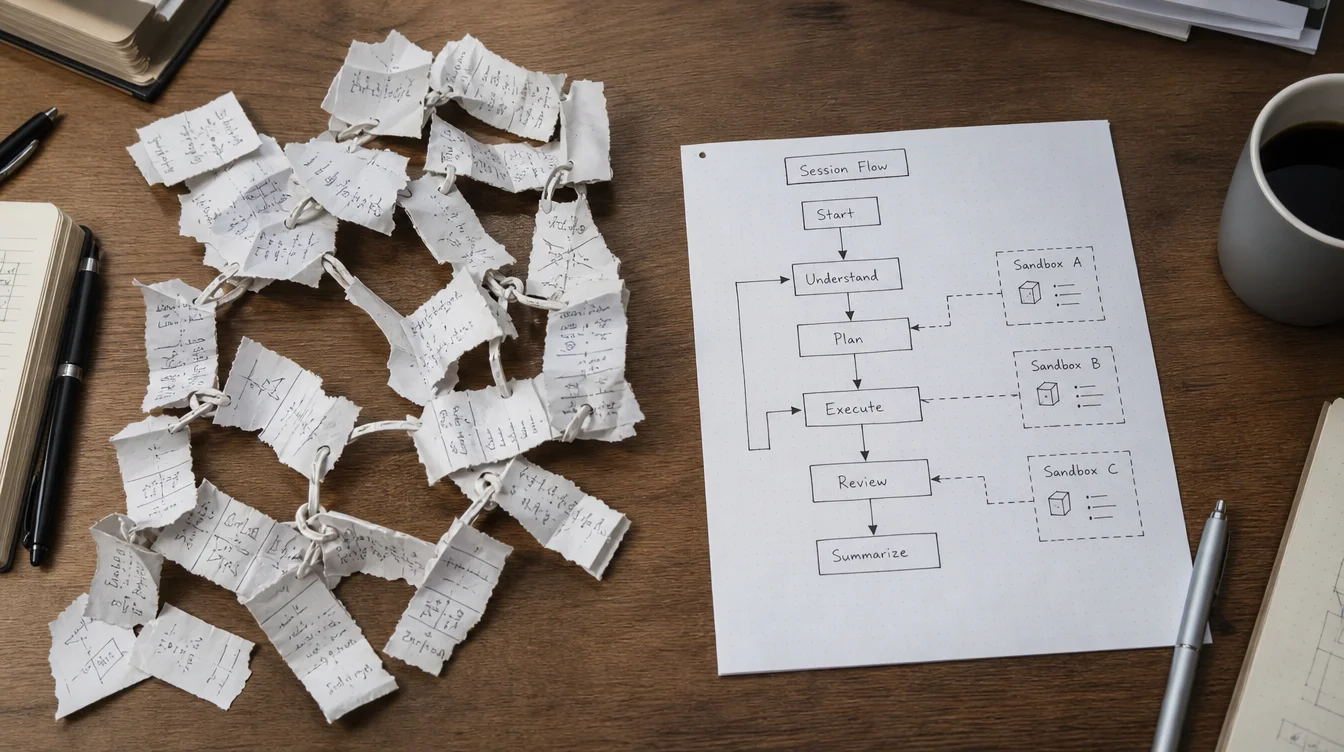 Dieses Bild wurde mit KI generiertProviderhiggsfieldModellgpt_image_2PromptDesk top-down view: tangled torn paper note chain on one side and a clean session flowchart sketch with sandbox boxes on the other, soft office light, metaphor for prompt chains vs harness, photorealistic, no logos, no readable brand text, 16:9
Auch eine selbst betriebene Sandbox macht die Agents API nicht ZDR-fähig. Für Architekturen in der EU und überall, wo Speicherdauer und Speicherort Vertragsgegenstand sind, ist das ein Ausschlusskriterium. Eine selbst betriebene Umgebung steuert die Ausführung, sie ändert aber weder Residenz noch Speicherung der Schnittstelle. Wer Selbstbetrieb als Abkürzung zur Compliance verkauft, verkauft Wunschdenken. Die Datenschutzangaben (Data Controls) gehören gelesen, und die Lücke gehört in die Architekturentscheidung statt in einen Anhang mit dem Titel „später klären“.
Die Sandbox ist der Ort, an dem Agenten Code ausführen, Dateien anfassen und Artefakte erzeugen, ohne dass das Produktivnetz zur Spielwiese wird. Die gehostete Variante ist schnell startbar, die selbst betriebene gibt Kontrolle über den Arbeitsbereich. Beide brauchen Regeln dazu, welche Befehle, Pfade, MCP-Server und Freigaben gelten. Ohne diese Grenzen bleibt die Sandbox ein Container, mit ihnen legt sie die Reichweite möglicher Schäden fest.
Zu den Grenzen zählen Token, parallele Unteragenten, Zulassungslisten für Werkzeuge, eine maximale Zahl von Schritten und Freigaben für zerstörerische Aktionen. Die Dokumentation zeigt mit multi_agent und max_concurrent_subagents einen Hinweis auf solche Begrenzungen. Die Idee lässt sich auch mit anderen Zahlen übernehmen.
Ebenso wichtig ist die Steuerung während der Sitzung. Menschen dürfen eingreifen, nachschärfen und stoppen. Wer Agenten startet und erst am Ende der Aufgabe wieder hinsieht, hat die Überwachung abgewählt. Entscheidend ist die Reproduzierbarkeit: Am Montagmorgen muss sich erklären lassen, warum ein Agent in der Nacht zwölf Werkzeuge nacheinander aufgerufen hat, und der Lauf muss sich nachstellen lassen. Eine Demo verzeiht Abweichungen, der Betrieb verzeiht sie nicht.
Die Schnittstelle hält den Sitzungszustand, damit Arbeit fortgesetzt werden kann. Sitzungen und veröffentlichte Artefakte lassen sich löschen, wenn sie nicht mehr gebraucht werden. Das Löschen gehört zur Governance und nicht zum Aufräumen am Ende.
Fünf Entscheidungen gehören vor der Migration schriftlich festgehalten
Vor einer Migration auf die Agents API sollten Teams fünf Punkte schriftlich entscheiden, bevor die Umstellung im Sprint landet.
- Sitzungsmodell: Festzulegen ist, welche Aufgaben über mehrere Runden laufen, wer steuern darf und wann gelöscht wird.
- Umgebung: Zu klären sind gehostete oder selbst betriebene Sandbox, die Verzeichnisse für Fähigkeiten und die MCP-Server auf der Zulassungsliste.
- Datenhaltung: Es gilt zu entscheiden, ob Residenz nur in den USA und fehlende ZDR für den Anwendungsfall akzeptabel sind oder ihn ausschließen. Der Selbstbetrieb ändert daran nichts.
- Bewertungsverfahren: Nötig sind Ausgangswerte vor der Migration und Messwerte danach. Die Aussagen von Ciridae, SafetyKit und Hypha gelten als Hypothesen und nicht als Kennzahlenvorlage.
- Kostenmodell: Token, Werkzeuge und Container-Raten werden getrennt erfasst, auch wenn OpenAI keine zusätzliche Gebühr für die Schnittstelle nennt.
Jede dieser Entscheidungen braucht Verantwortliche, ein Datum und ein Ausstiegskriterium. Ohne Ausstieg ist der Harness nur ein neuer Weg in die Abhängigkeit von einem Hersteller. Wechselbarkeit gilt auch für die Zulieferkette aus Modell, Plattform und Harness. Wer sie untrennbar verschweißt, baut eine Abhängigkeit mit freundlicher Demo, wie die Linie zur NVIDIA-Übernahme und Hugging-Face-Zulieferkette zeigt.
Prompt-Ketten dürfen bleiben, wenn sie bewusst als Prototypen geführt und als nicht produktionsfähig markiert sind. Wer sich für den Harness entscheidet, legt Grenzen und Bewertungsverfahren am selben Tag fest und nicht später, wenn es skaliert. Wer Agenten ohne Bewertungsverfahren live schaltet, testet im Betrieb. Fehlen Grenzen, sponsert er Überraschungen, und ohne Sandbox wächst die Reichweite möglicher Schäden.
Für die nächste Architekturrunde genügen fünf Seiten: Ablauf der Sitzung, Regeln der Umgebung, Ausgangswerte des Bewertungsverfahrens, Kostenspalten und Datenhaltung. Das schlägt fünfzig Prompt-Varianten. Enterprise-Agenten skalieren mit gemanagtem Harness, Sandbox, Bewertung, Grenzen und Wiederaufnahme, während ein weiterer Systemprompt keine Orchestrierung ersetzt.
Was halten Sie von dem Thema? Hier können Sie mit anderen Leserinnen und Lesern ins Gespräch gehen.
Mitreden & diskutieren
Ihre Meinung zählt — teilen Sie Gedanken, Fragen oder Erfahrungen zu diesem Artikel.